



Bạn đã nghe nói về nghịch lý của Moravec chưa? Nghịch lý tuyên bố rằng lý luận tiên tiến đòi hỏi rất ít sức mạnh tính toán cho hệ thống Trí tuệ nhân tạo (AI), đồng thời thực hiện các kỹ năng động cơ nhận thức mà con người coi là tài nguyên tính toán khổng lồ. Về bản chất, các nhiệm vụ logic phức tạp dễ dàng hơn đối với AI so với các nhiệm vụ cảm giác cơ bản mà bản năng của con người có thể hoàn thành. Nghịch lý này nhấn mạnh sự khác biệt giữa AI và khả năng nhận thức của con người ở giai đoạn này.
Mọi người vốn đã đa phương thức. Mỗi người trong chúng ta giống như một thiết bị đầu cuối thông minh thường cần đến trường để được giáo dục (được đào tạo), nhưng mục đích và kết quả của việc đào tạo và học tập đó là chúng ta có khả năng làm việc và sống tự chủ mà không phải luôn dựa vào các hướng dẫn bên ngoài và điều khiển.
Chúng ta tìm hiểu về thế giới xung quanh chúng ta thông qua nhiều phương thức cảm giác như thị giác, lời nói, âm thanh, cảm ứng, hương vị và mùi để phân tích, lý trí, quyết định và hành động.
Sau nhiều năm kết hợp cảm biến và tiến hóa AI, robot phần lớn được trang bị cảm biến đa phương thức ở giai đoạn này. Khi chúng tôi mang thêm sức mạnh tính toán cho các thiết bị cạnh như robot, các thiết bị này đang trở nên thông minh hơn và thông minh hơn, có khả năng cảm nhận môi trường xung quanh, hiểu và giao tiếp bằng ngôn ngữ tự nhiên, có được haptics thông qua các giao diện cảm biến kỹ thuật số, cũng như cảm nhận được lực cụ thể của robot, Vận tốc góc, và thậm chí từ trường xung quanh robot thông qua sự kết hợp của gia tốc kế, con quay hồi chuyển & từ kế, v.v.
Hướng tới một kỷ nguyên mới của robot và nhận thức máy
Trước Transformer và các mô hình ngôn ngữ lớn (LLM), việc thực hiện đa phương thức trong AI thường yêu cầu sử dụng nhiều mô hình riêng biệt chịu trách nhiệm cho các loại dữ liệu khác nhau (văn bản, hình ảnh, âm thanh) và tích hợp các phương thức khác nhau thông qua một quy trình phức tạp.
Với sự ra đời của các mô hình máy biến áp và LLM, đa phương thức đã được tích hợp hơn, cho phép một mô hình duy nhất xử lý đồng thời và hiểu nhiều loại dữ liệu, dẫn đến các hệ thống AI có khả năng cảm nhận toàn diện hơn về môi trường của chúng. Sự thay đổi này đã cải thiện đáng kể hiệu quả và hiệu quả của các ứng dụng AI đa phương thức.
Trong khi các LLM như GPT -3 chủ yếu dựa trên văn bản, ngành công nghiệp đã đạt được tiến bộ nhanh chóng đối với đa phương thức. Từ clip của Openai và Dall-E, và bây giờ Sora và GPT -4 o, là những ví dụ về các mô hình đã chuyển sang đa phương thức và tương tác máy tính con người tự nhiên hơn. Ví dụ, clip hiểu hình ảnh kết hợp với ngôn ngữ tự nhiên, do đó thu hẹp khoảng cách giữa thông tin trực quan và văn bản; Dall-E nhằm mục đích tạo hình ảnh dựa trên các mô tả văn bản. Chúng tôi thấy mô hình Google Gemini trải qua một sự tiến hóa tương tự.
Năm 2024, tiến hóa đa phương thức tăng tốc. Vào tháng 2, Openai đã phát hành Sora, tạo ra các video thực tế hoặc giàu trí tưởng tượng dựa trên các mô tả văn bản. Khi bạn nghĩ về nó, điều này có thể cung cấp một con đường đầy hứa hẹn để xây dựng các trình mô phỏng thế giới toàn cầu, hoặc trở thành một công cụ quan trọng để huấn luyện robot. Sau ba tháng, GPT -4 o đã cải thiện đáng kể hiệu suất của tương tác robot của con người và có thể lý luận trong thời gian thực giữa âm thanh, tầm nhìn và văn bản. Kết hợp thông tin văn bản, hình ảnh và âm thanh để đào tạo một mô hình mới từ đầu đến cuối loại bỏ hai chuyển đổi phương thức từ phương thức đầu vào sang văn bản và sau đó từ văn bản sang phương thức đầu ra, từ đó cải thiện đáng kể hiệu suất.
Trong cùng một tuần vào tháng Hai, Google đã phát hành Gemini 1.5, giúp mở rộng đáng kể độ dài bối cảnh lên 1 triệu mã thông báo. Điều này có nghĩa là 1.5 Pro có thể xử lý một lượng lớn thông tin cùng một lúc, bao gồm một giờ video, 11 giờ âm thanh và cơ sở mã có chứa hơn 30, 000 dòng mã hoặc 700, 000} Words.gemini 1.5 được xây dựng trên nghiên cứu hàng đầu của Google về Transformer và Kiến trúc chuyên gia thành viên hỗn hợp (MOE) và các mô hình 2B và 7B nguồn mở có thể được triển khai ở phía cạnh. Tại hội nghị I/O của Google vào tháng 5, ngoài việc nhân đôi chiều dài của bối cảnh và phát hành một loạt các công cụ và ứng dụng AI tổng quát, Google đã khám phá tầm nhìn của mình về tương lai của Project Astra, một trợ lý AI đa năng chung xử lý thông tin đa phương thức , hiểu bối cảnh mà người dùng được đặt và tương tác với mọi người trong các cuộc trò chuyện theo một cách rất tự nhiên.
Là công ty đằng sau LLM LLM nguồn mở, Meta cũng tham gia theo dõi Trí tuệ nhân tạo nói chung (AGI).
Đa phương thức thực sự này làm tăng đáng kể mức độ thông minh máy móc và sẽ dẫn đến các mô hình mới cho nhiều ngành công nghiệp.
Ví dụ, robot từng rất đồng nhất, với một số cảm biến và khả năng vận động, nhưng nói chung chúng không có "não" để học những điều mới và thích nghi với môi trường không có cấu trúc và lạ.
LLM đa phương thức dự kiến sẽ biến đổi khả năng của robot để phân tích, lý trí và học hỏi, chuyển chúng từ chuyên môn sang khái quát hóa. PC, máy chủ và điện thoại thông minh là các nhà lãnh đạo trong các nền tảng điện toán đa năng và có thể chạy nhiều loại ứng dụng phần mềm khác nhau để đạt được nhiều chức năng khác nhau. Tổng quát hóa sẽ giúp mở rộng quy mô, tạo ra các nền kinh tế theo quy mô và giá cả có thể giảm đáng kể khi họ mở rộng quy mô, dẫn đến một chu kỳ nhận con nuôi trong nhiều lĩnh vực hơn.
Elon Musk nhận thấy những lợi ích của công nghệ tổng quát từ rất sớm, khi các robot của Tesla phát triển từ Bumblebee vào năm 2022 đến Optimus Gen 1, được công bố vào tháng 3 năm 2023, và Gen 2, đã công bố vào cuối năm 2023, với khả năng hoạt động và học tập ngày càng tăng. Trong quá khứ 6-12 tháng, chúng ta đã chứng kiến một số bước đột phá trong lĩnh vực robot và robot hình người.
Các công nghệ mới đằng sau robot thế hệ tiếp theo và trí thông minh thể hiện
Không có nghi ngờ rằng chúng tôi vẫn còn rất nhiều việc phải làm trước khi hiện thân của trí thông minh đạt được sản xuất hàng loạt. Chúng tôi cần các thiết kế nhẹ hơn, thời gian chạy dài hơn và các nền tảng điện toán cạnh mạnh hơn, mạnh hơn để xử lý và hợp nhất thông tin dữ liệu cảm biến để đưa ra quyết định kịp thời và các hành động kiểm soát.
Và chúng tôi đang hướng tới việc tạo ra robot hình người; Hàng ngàn năm của nền văn minh nhân loại đã tạo ra môi trường phổ biến được thiết kế cho con người, và các hệ thống robot hình người dự kiến sẽ có thể tương tác thoải mái với con người và môi trường và thực hiện các hoạt động cần thiết trong môi trường tồn tại của con người do sự giống nhau của chúng với hình thức. Các hệ thống này sẽ rất phù hợp để xử lý các nhiệm vụ bẩn thỉu, nguy hiểm và nhàm chán như chăm sóc bệnh nhân và phục hồi chức năng, làm việc trong ngành khách sạn, giảng dạy hoặc học tập học tập trong lĩnh vực giáo dục và các nhiệm vụ nguy hiểm như phản ứng thảm họa và xử lý vật liệu nguy hiểm . Các ứng dụng như vậy sử dụng các thuộc tính của người hình người để tạo điều kiện cho các tương tác tự nhiên của con người, hành động trong không gian tập trung vào con người và thực hiện các nhiệm vụ thường khó đối với robot truyền thống.
Nhiều công ty AI và robot đang đưa ra nghiên cứu và hợp tác mới xung quanh cách huấn luyện robot với lý do tốt hơn và lên kế hoạch trong môi trường không có cấu trúc mới. Là "bộ não" mới của robot, các mô hình được đào tạo trước trên một lượng lớn dữ liệu có khả năng khái quát hóa tuyệt vời, cho phép robot nhìn và hiểu môi trường của chúng một cách toàn diện hơn, điều chỉnh chuyển động và hành động của chúng dựa trên phản hồi cảm giác và tối ưu hóa hiệu suất của chúng Trong một loạt các môi trường năng động.
Như một ví dụ thú vị, chú chó robot của Boston Dynamics, Spot, có thể đóng vai trò hướng dẫn viên du lịch trong bảo tàng, tương tác với khách truy cập, giới thiệu chúng với các triển lãm khác nhau và trả lời câu hỏi của họ. Có thể khó tin, nhưng trong trường hợp sử dụng này, các màn trình diễn giải trí, tương tác và tinh tế của Spot là quan trọng hơn so với đảm bảo các sự kiện là chính xác.
Máy biến áp robot: Bộ não mới của robot
Máy biến áp Robotics (RT) đang phát triển nhanh chóng để dịch các đầu vào đa phương thức trực tiếp thành mã hành động. Google DeepMind's RT -2 thực hiện cũng như người tiền nhiệm của nó, RT -1, với tỷ lệ thành công gần 100% khi thực hiện các tác vụ đã được nhìn thấy trước đó. Tuy nhiên, khi được đào tạo với lòng bàn tay (một mô hình ngôn ngữ đa phương thức được thể hiện theo định hướng robot) và Pali-x (mô hình ngôn ngữ đa ngôn ngữ và đa ngôn ngữ quy mô lớn, không được thiết kế cụ thể cho robot), RT -2 có khả năng khái quát hóa tốt hơn tốt hơn và vượt trội so với RT -1 trên các tác vụ không nhìn thấy.
Microsoft đã giới thiệu Llava, một trợ lý ngôn ngữ và tầm nhìn quy mô lớn. Được thiết kế ban đầu cho các tác vụ dựa trên văn bản, Llava tận dụng sức mạnh của GPT -4 để tạo ra một mô hình mới cho các hướng dẫn đa phương thức để tuân theo dữ liệu, tích hợp liền mạch các thành phần văn bản và trực quan, có thể hữu ích cho các tác vụ robot. Sau khi giới thiệu, Llava đã thiết lập các hồ sơ mới cho các nhiệm vụ trò chuyện đa phương thức và các câu hỏi khoa học, đã vượt quá khả năng trung bình của con người.
Như đã đề cập trước đó, sự đột phá của Tesla vào robot mục đích chung và AI có ý nghĩa không chỉ bởi vì nó được thiết kế để sản xuất quy mô và hàng loạt, mà còn bởi vì nền tảng công nghệ tự lái mạnh (FSD) mạnh mẽ của Tesla cho ô tô có thể được sử dụng cho robot. Tesla cũng có một trường hợp sử dụng sản xuất thông minh để áp dụng Optimus vào quy trình sản xuất xe năng lượng mới.
Cánh tay là nền tảng của tương lai của robot
ARM tin rằng bộ não robot, cả "não lớn" và "bộ não nhỏ", phải là một hệ thống điện toán AI không đồng nhất mang lại hiệu suất vượt trội, phản ứng thời gian thực và hiệu quả năng lượng.
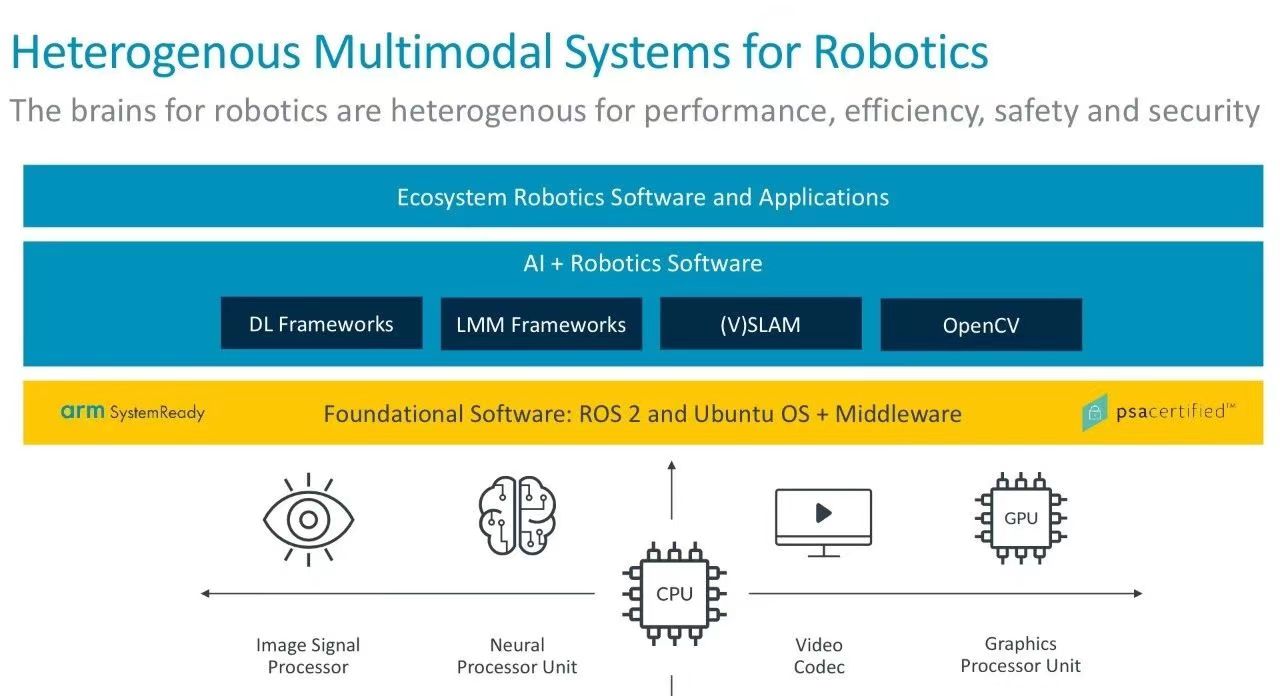
Robotics liên quan đến một loạt các tác vụ, bao gồm tính toán cơ bản (ví dụ: gửi và nhận tín hiệu đến và từ động cơ), xử lý dữ liệu nâng cao (ví dụ, giải thích dữ liệu hình ảnh và cảm biến) và chạy các LLM đa phương thức được đề cập trước đó. CPU rất phù hợp cho các nhiệm vụ có mục đích chung, trong khi bàn đạp khí AI và GPU có thể xử lý hiệu quả hơn các nhiệm vụ xử lý song song, như học máy (ML) và xử lý đồ họa. Bàn đạp gas bổ sung như bộ xử lý tín hiệu hình ảnh và codec video cũng có thể được tích hợp để tăng cường khả năng thị lực của robot và hiệu quả lưu trữ/truyền tải. Ngoài ra, CPU nên có khả năng đáp ứng thời gian thực và cần có khả năng chạy các hệ điều hành như gói Linux và ROS.
Khi được mở rộng sang ngăn xếp phần mềm robot, lớp hệ điều hành cũng có thể yêu cầu hệ điều hành thời gian thực (RTO) có thể xử lý đáng tin cậy các nhiệm vụ quan trọng về thời gian, cũng như phân phối Linux được tùy chỉnh cho robot, chẳng hạn như ROS, có thể cung cấp Các dịch vụ được thiết kế cho các cụm điện toán không đồng nhất. Chúng tôi tin rằng các tiêu chuẩn và các chương trình chứng nhận được tài trợ bởi ARM như SystemReady và PSA được chứng nhận sẽ giúp mở rộng quy mô phát triển phần mềm robot. SystemReady được thiết kế để đảm bảo rằng các phân phối HĐH phong phú tiêu chuẩn chạy trên một loạt các chip trên chip (SOC) dựa trên kiến trúc ARM, trong khi PSA được chứng nhận giúp đơn giản hóa các giải pháp triển khai bảo mật để đáp ứng các yêu cầu về bảo mật và quy định khu vực đối với các thiết bị được kết nối.
Những tiến bộ trong các mô hình đa phương thức quy mô lớn và AI tạo ra một kỷ nguyên mới trong sự phát triển của robot AI và robot hình người. Cùng với máy tính AI và hệ sinh thái, hiệu quả năng lượng, bảo mật và an toàn chức năng là điều cần thiết để làm cho robot trở nên chính thống trong kỷ nguyên mới này. Bộ xử lý ARM đã được sử dụng rộng rãi trong robot và chúng tôi mong muốn được hợp tác chặt chẽ với hệ sinh thái để biến cánh tay thành nền tảng của tương lai của AI Robotics.